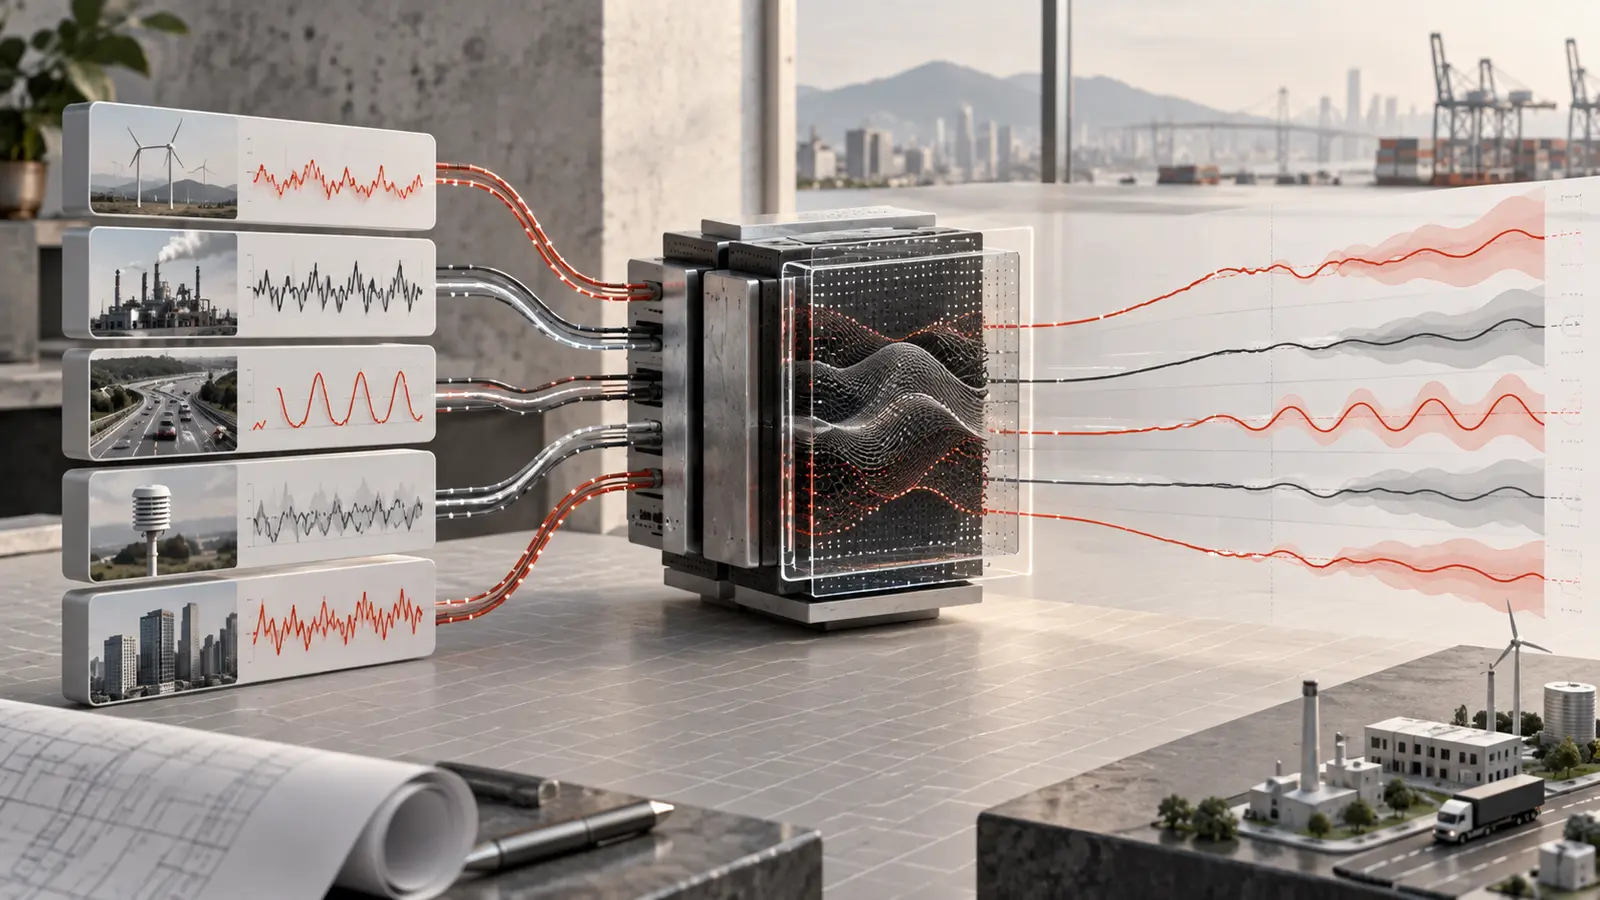
IBM 9 сентября 2026 года выпустила Granite Time Series PatchTST-FM-r2 — новую открытую модель для прогнозирования временных рядов. Это не новость про инвестиции и не корпоративная витрина, а конкретный модельный релиз: веса, архитектура, inference pipeline и код для воспроизведения benchmark опубликованы на Hugging Face.
Если сказать проще, модель нужна для задач, где есть последовательность измерений и нужно предсказать продолжение: спрос, цены, энергопотребление, трафик, телеметрия, нагрузка серверов, транзакции, датчики производства. Главная ставка IBM — zero-shot forecasting: модель можно применить к новым рядам без отдельного обучения под каждый датасет.
Что именно выпустила IBM
Granite Time Series PatchTST-FM-r2 — продолжение семейства IBM Granite Time Series и развитие предыдущей версии PatchTST-FM-r1. По данным IBM, новая модель имеет около 385 млн параметров, поддерживает контекст до 8192 шагов и строит не только одну линию прогноза, но и вероятностные прогнозы через голову на 99 квантилей.
Для бизнеса это важнее, чем звучит. В реальной задаче редко хватает ответа «завтра будет 120 заказов». Обычно нужен диапазон: что вероятно, где риск, насколько широк коридор неопределённости. Прогноз спроса, нагрузки или цены без оценки разброса легко превращается в красивую, но хрупкую цифру.
Модель опубликована в Hugging Face Hub как ibm-granite/granite-timeseries-patchtst-fm-r2. На странице модели указана лицензия OpenMDW 1.0, а в описании релиза IBM пишет о двойном лицензировании OpenMDW 1.0 и Apache 2.0: пользователь может выбрать подходящий вариант. Для прикладных команд это снимает часть типичной боли вокруг открытых моделей: можно не только посмотреть демо, но и обсуждать коммерческое применение с юристами и архитекторами на понятной основе.
Почему это не просто ещё один Transformer
Название PatchTST здесь не случайно. Модель работает с временным рядом как с набором фрагментов-патчей: вместо того чтобы обрабатывать каждую точку отдельно, она смотрит на куски последовательности. Такой подход хорошо подходит для длинных рядов, где важны и локальные колебания, и дальние зависимости.
Во второй версии IBM серьёзно изменила внутреннюю архитектуру. Обычные transformer-блоки заменены conformer-блоками: внутри сочетаются self-attention и temporal convolution. Attention полезен для дальних связей, а свёртка помогает лучше ловить близкие по времени закономерности. Временной ряд как раз часто состоит из двух слоёв: есть общий сезонный или циклический рисунок, но есть и короткие всплески, провалы, задержки, шум датчиков.
Ещё одно изменение — перекрывающиеся патчи. IBM описывает патчи длиной 16 со stride 8, Hamming-window weighting при обучении и overlap-and-add при inference. Практический смысл такой: границы между фрагментами не должны превращаться в швы на прогнозе. Если модель предсказывает кусками, эти куски нужно аккуратно склеивать, иначе на выходе можно получить рваную линию вместо нормального временного сигнала.
Также количество блоков выросло с 20 до 30, добавлена нормализация перед головой модели, а корпус обучения расширен. Это не косметические изменения вокруг старой модели, а полноценный r2-релиз с другой инженерной конструкцией.
Что значит zero-shot для временных рядов
В классическом подходе команда часто строит отдельную модель под каждую задачу: один прогноз для продаж, другой для запасов, третий для нагрузки, четвёртый для датчиков. Потом всё это нужно поддерживать, переобучать, мониторить, объяснять и чинить после смены сезонности.
Foundation model для временных рядов предлагает другую механику. Берём предобученную модель, отдаём ей свежую историю ряда и получаем прогноз без обязательного fine-tuning. Это не магия и не гарантия качества на любой таблице, но это резко снижает порог первого теста. Можно быстро проверить, есть ли у модели полезный сигнал на ваших данных, прежде чем строить отдельный ML-контур.
Для малого и среднего бизнеса это особенно интересно. Не у каждой компании есть команда data science, которая будет месяцами собирать forecasting pipeline. Но почти у каждой есть временные ряды: заявки по дням, выручка, склад, звонки, рекламные расходы, остатки, загрузка мастеров, повторные обращения. Если открытая модель даёт приличный старт без отдельного обучения, её можно использовать как быстрый эксперимент: сравнить с текущим способом планирования и принять решение по фактам.
Что показали benchmark и лицензирование
IBM опирается на GIFT-Eval — benchmark для проверки моделей прогнозирования временных рядов на разных сценариях. В релизе указано, что по состоянию на 8 сентября 2026 года PatchTST-FM-r2 занимает второе место среди replicable zero-shot моделей по CRPS и MASE, если исключить утечку test data и смотреть воспроизводимые результаты. Среди моделей с permissive commercial-friendly лицензией IBM называет r2 лучшей в этой категории.
Здесь важно читать формулировки аккуратно. Это не означает, что модель всегда будет лучшей на конкретном складе, в конкретной рознице или в конкретной промышленной телеметрии. Benchmark показывает сильный общий уровень, но рабочее решение всё равно проверяется на своих исторических данных. Особенно если прогноз связан с деньгами: закупками, SLA, производственным планом или ценами.
Отдельная хорошая деталь — прозрачность обучения. IBM перечисляет четыре источника корпуса: выбранные датасеты из GiftEvalPretrain, синтетические данные на базе KernelSynth с изменёнными периодическими ядрами, TSMixup-корпус по подходу Chronos, но без датасетов из evaluation-set GIFT-Eval, и около 500 тысяч синтетических последовательностей CauKer длиной 4096.
Для enterprise-команд это почти так же важно, как метрики. Когда модель идёт в production, вопрос звучит не только «какая ошибка на leaderboard», но и «на чём она училась, есть ли риск утечки benchmark, что с лицензиями и можем ли мы объяснить выбор аудитору». Здесь у IBM есть что положить в папку model governance.
Как попробовать
Самый короткий путь — Hugging Face Hub и пакет Granite TSFM. IBM показывает установку через pip install "granite-tsfm>=0.3.9", загрузку модели ibm-granite/granite-timeseries-patchtst-fm-r2 и запуск через TimeSeriesForecastingPipeline. В примере модель берёт последние 512 точек временного ряда ETTh и строит прогноз на 64 шага вперёд с квантилями 0.1, 0.5 и 0.9.
Для своего проекта вместо демонстрационного датасета можно подставить регулярный ряд: спрос по дням, CPU utilization по минутам, энергопотребление, цену, поток заказов, трафик или промышленный датчик. Дальше начинается нормальная инженерная работа: привести частоту, проверить пропуски, зафиксировать горизонт прогноза, выбрать метрику ошибки и сравнить результат с текущим baseline.
Я бы не начинал с внедрения в боевую автоматизацию. Сначала стоит собрать маленький backtest: взять несколько прошлых периодов, на каждом дать модели только историю до выбранной даты и сравнить прогноз с тем, что случилось потом. Если модель стабильно помогает, тогда можно думать о расписании inference, мониторинге ошибок, алертах и ограничениях на автоматические решения.
Где это может быть полезно
Самый очевидный сценарий — спрос и запасы. Интернет-магазин, производство или сервисная компания могут прогнозировать заказы, загрузку, остатки и сезонные пики. Даже если прогноз не идеален, он может быть полезнее ручного «на глаз», особенно когда есть много номенклатуры и разные циклы.
Второй сценарий — инфраструктура и техническая эксплуатация. Временные ряды есть в логах, метриках серверов, очередях, биллинге, сетевом трафике, ошибках приложений. Модель прогнозирования здесь не заменяет мониторинг, но может заранее подсказать, что нагрузка выходит из обычного коридора или что через несколько часов закончится ресурс.
Третий сценарий — промышленность и IoT. Датчики дают регулярные сигналы, в которых важны тренды, периодичность, шум и внезапные отклонения. Foundation model не отменяет предметную экспертизу инженера, но может ускорить первичную аналитику там, где раньше приходилось долго собирать отдельную модель под каждый тип оборудования.
Четвёртый сценарий — финансы и цены. Здесь нужно быть особенно осторожным: прогноз цены не равен торговому сигналу и не снимает риск. Но как исследовательский инструмент для временных рядов модель можно тестировать на волатильности, сезонности, операционных показателях и сценарном планировании.
Что пока не стоит додумывать
В релизе нет обещания, что PatchTST-FM-r2 решит любую forecasting-задачу без подготовки данных. Zero-shot не означает «без проверки». Временные ряды часто ломаются из-за смены режима: новая акция, изменение логистики, сбой датчика, переезд склада, изменение продукта, праздники, разрыв в учёте. Модель может хорошо обобщать прошлые закономерности и всё равно ошибаться, когда бизнес изменился.
Также не стоит путать открытую модель с готовым SaaS-продуктом. Hugging Face карточка даёт модель, код и пример использования, но production-контур остаётся на стороне команды: хранение данных, расписание расчётов, мониторинг дрейфа, права доступа, контроль затрат, fallback при ошибке и понятные правила, кто принимает итоговое решение.
Тем не менее релиз важный. Мы привыкли обсуждать большие языковые модели, кодовые агенты и генерацию картинок, а прогнозирование временных рядов часто остаётся в тени. Granite Time Series PatchTST-FM-r2 показывает другой зрелый кусок рынка: открытые foundation models для прикладных числовых данных, где ценность измеряется не эффектным диалогом, а снижением ошибки прогноза и более быстрым запуском эксперимента.
Источник
Основной источник — публикация IBM Research на Hugging Face от 9 сентября 2026 года и карточка модели ibm-granite/granite-timeseries-patchtst-fm-r2.